在线数据处理 加速产品迭代的新引擎
在当今快速变化的数字时代,产品迭代的速度往往决定了企业的市场竞争力。传统软件开发模式中,新功能的开发和部署常常面临冗长的周期,从需求分析到上线维护,每一个环节都可能成为瓶颈。随着在线数据处理技术的成熟与普及,这一局面正在发生根本性的改变。通过将数据处理能力实时化、在线化,企业能够显著加快新功能的开发部署速度,有效缩短产品迭代周期,从而更敏捷地响应市场反馈和用户需求。
在线数据处理的核心在于“实时”与“连续”。相较于传统的批处理方式——将数据收集后延迟处理,在线数据流处理允许系统对源源不断产生的数据进行即时分析、转换和响应。这意味着,当用户与产品交互时产生的行为数据、日志信息或业务事件,可以立即被处理并用于指导功能优化。例如,在A/B测试中,产品团队可以实时监控新功能的关键指标变化,快速判断其效果,而不必等待数小时甚至数天的报表生成。这种即时反馈闭环极大压缩了“开发-测试-学习-调整”的循环时间,使迭代周期从数周缩短至数天甚至数小时。
具体而言,在线数据处理在加速功能部署方面体现在多个层面:
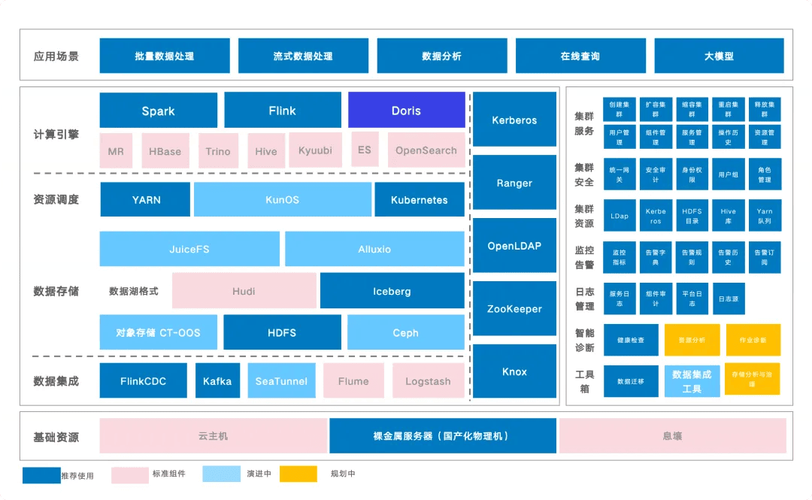
其一,实时数据管道支撑快速功能验证。借助流式处理框架(如Apache Kafka、Flink等),开发团队可以构建低延迟的数据管道,将新功能产生的实验数据实时推送至分析平台。产品经理和工程师能够当场观察用户行为变化,及时发现问题或确认价值,避免了传统离线分析带来的滞后性。这种“边开发边验证”的模式降低了试错成本,加快了合规格功能的认定和扩量部署。
其二,在线特征存储与模型部署加快智能功能上线。许多产品功能依赖于机器学习模型(如推荐系统、风控引擎)。在线数据处理平台可以实时计算特征向量,并将训练好的模型快速部署为在线推理服务。当新模型或新策略就绪时,团队能够通过在线数据处理链路实时回填数据、监测效果,从而在数小时内完成从模型训练到生产环境灰度发布的流程。这不仅缩短了智能功能的迭代周期,也提升了模型对动态数据的适应能力。
其三,持续集成与持续部署(CI/CD)与实时数据反馈结合。现代DevOps实践中,自动化测试和部署工具已将发布周期压缩至分钟级,而在线数据处理进一步赋能部署后的实时监控与快速回滚。通过实时收集生产环境中的性能指标与用户反馈数据,系统能够自动触发告警或 even 回滚机制,使得每次功能部署的风险可控。团队因此敢于更频繁地发布小版本迭代,形成“小步快跑”的部署节奏,显著提升产品更新的频率和质量。
其四,数据驱动的决策文化促进跨团队协作。在线数据处理使业务、开发和运维团队共享同一套实时数据视图。当某个功能运行时产生实时业务指标,相关方能立即基于数据展开讨论,减少沟通等待和决策停滞。这种透明、高效的合作模式消除了职能边界的等待时间,使得功能从概念到上线的端到端周期大幅缩短。
实现在线数据处理并非一蹴而就,需要企业在技术基础设施和文化上给予投入。技术层面,需构建可扩展的流处理架构、数据治理体系和自动化运维能力;文化层面,需培育数据驱动的实验精神,鼓励快速迭代与持续学习。但无疑是,在线数据处理已成为加速产品迭代的关键基础设施。走在这一趋势前列的企业,正以数倍于以往的速度将想法转化为可用功能,在激烈的市场竞争中赢得宝贵的时间窗口。随着边缘计算与5G等技术的发展,在线数据处理将更加贴近用户端,进一步拓宽可实现的迭代效率边界。
如若转载,请注明出处:http://www.btrsgnv.com/product/26.html
更新时间:2026-11-03 00:12:39